图模式串讲:从 recipe 到硬件执行
本文最后更新于 2026年9月30日
本文是 LLM 推理图模式的串讲底稿,简单理解图下沉与图编译的基本原理,并且跟着 recipe 图模式开关找到执行入口。
1. 速通:同一个 forward,为什么换一种执行方式就能更快?
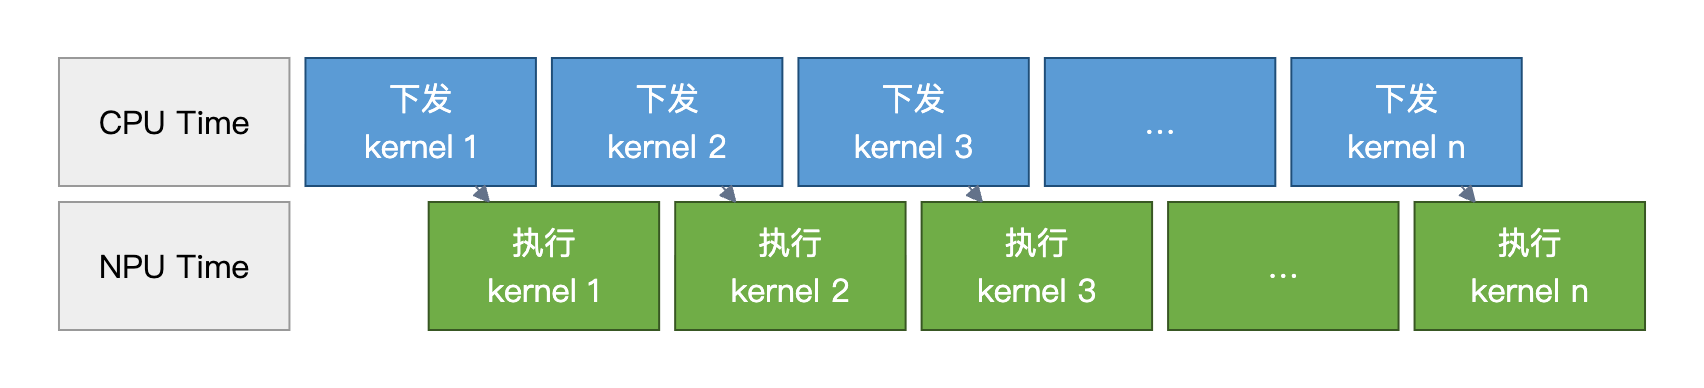
eager 模式单算子下发,Host 要执行框架分发、数据准备、算子准备和任务提交;Device 要调度任务、搬运数据、执行 kernel,并等待必要的同步。
图模式的收益有两个来源:减少反复组织工作的开销,以及改变计算和数据搬运的安排。 对应后面的图捕获回放与图编译。
Host 和 Device 通常异步工作,时间会重叠,不能把所有 CPU 时间与所有 kernel 时间直接相加当作端到端耗时。看 trace 时,先找关键路径上 Device 在等什么。
Host Bound 在 timeline 上长什么样?
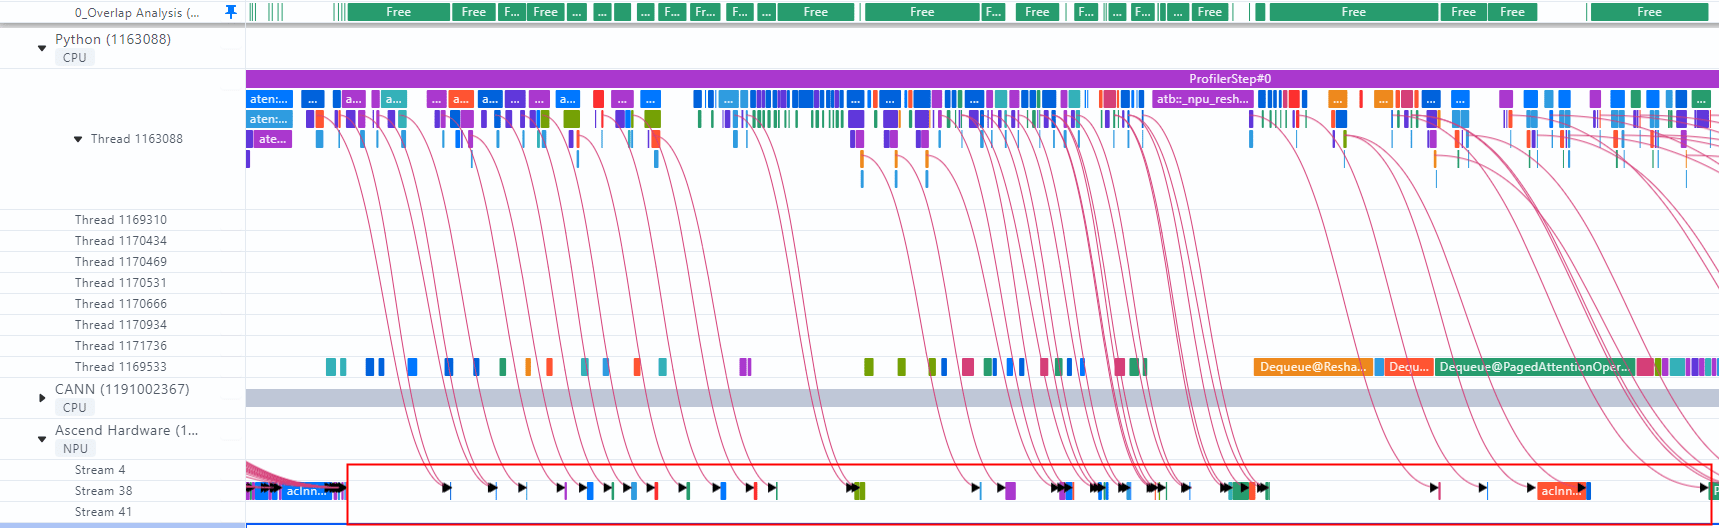
图片来源:vLLM-Ascend 推理优化:Eager 模式调度开销。该图是具体模型案例,用于说明判读方法,不代表所有 Eager workload 都必然 Host Bound。
这张真实 Profiling 来自 DeepSeek-V3 的 MLA Eager 执行案例。上方是 CPU 侧工作,下方是 NPU Stream;红色连线表示 Host 工作与 Device Task 的对应关系。红框中的短 Task 之间存在大量白色间隔,说明 Device 很快做完了手上的工作,却没有及时拿到下一项任务。此时限制吞吐的不是某个 kernel 的算力,而是 Host 向 Device 持续“下任务”的速度。
逐算子执行时,Host 可能要为每个小 kernel 重复完成一部分工作:
- 执行 Python 与框架分发逻辑,解析算子、shape、dtype、format 和属性。
- 计算或查询 tiling,确定分核策略、workspace 大小和运行参数。
- 准备输入 / 输出描述、Device 地址、workspace、stream 与依赖关系,处理必要的内存申请、复用、拷贝或同步。
- 选择或加载可执行的 kernel 二进制,组织 launch 参数,将 Runtime Task 提交到对应的 stream。
如果单个 kernel 在 Device 上只执行几十微秒,而 Host 准备和下发下一项任务需要更久,那么这些下发间隔就会直接变成 NPU 空洞,AI Core 利用率也随之下降。图捕获、图下沉或 replay 的重要价值,就是把其中可重复的准备与任务组织工作提前完成,让 Device 更连续地消费已经准备好的任务。
如果我们能把接下来一段时间 NPU 要执行的算子都提前准备好,然后下一一条执行依次执行这些算子,这就是图模式。
Eager:逐算子下发
图模式:复用已准备的执行过程
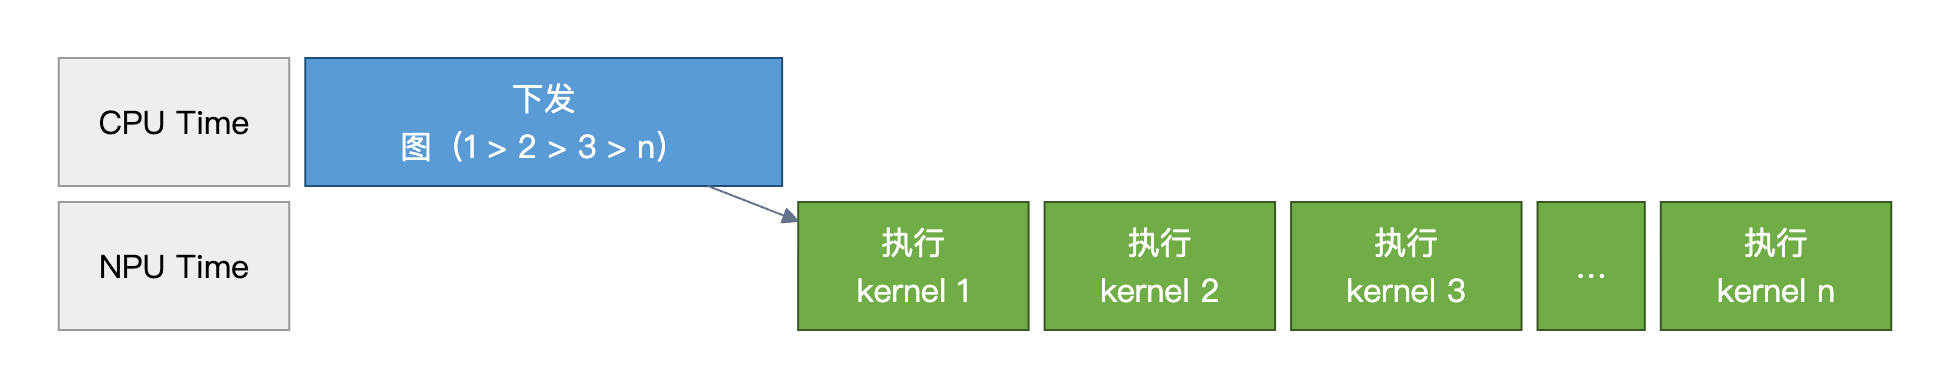
来源:recipe 图模式原理,图 1、图 2,直接复制 Mermaid 源码。两图为执行示意,实际 Host 提交与 Device 执行可以重叠。
2. 在 cann-recipes-infer 中开启图模式
核心开关是模型 YAML 中的 model_config.exe_mode。 在模型和运行环境已按对应 recipe 配置好的前提下,修改这个配置,再用原来的推理入口启动即可,无需自己添加 torch.compile。
2.1 修改模型配置
以 Qwen3-8B 为例,编辑 models/qwen/config/qwen3_8b_1tp.yaml,在现有 model_config 下修改:
1 | |
这里只展示图模式开关,其余权重路径、设备、并行和输入配置沿用原文件。
exe_mode |
执行方式 |
|---|---|
eager |
单算子执行,用作对照 |
npugraph_ex |
开启 NPU Graph EX 图模式 |
ge_graph |
开启 GE 图模式 |
切换 GE 时,将 exe_mode 改成 ge_graph,并将 enable_dynamic_graph 设为 false,与当前 recipe 的 GE 静态图路径保持一致。编译缓存、静态 kernel 等属于额外优化,不是开启图模式的必需项。
2.2 按原入口启动
在 cann-recipes-infer 仓库根目录运行:
1 | |
其他模型使用各自 recipe 的模型名和 YAML。启动后,框架会读取 exe_mode,在预热阶段完成相应准备,再进入正式推理;首次准备耗时应与后续稳态推理耗时分开看。
当前这条 executor 路径主要对 Decode 启用图模式,Prefill 仍走 Eager。 因此比较开关效果时,重点看预热后的 Decode 耗时。
依据:Qwen 启动说明、执行模式配置、Decode 执行分支。
3. Runtime、Driver 与硬件
简单理解 CANN 的调度体系。
3.1 从一次 Tensor 运算向下看
| 层次 | 负责的事情 | 适合问的问题 |
|---|---|---|
| 模型 / 推理框架 | forward、请求调度、KV Cache、并行策略 | 这一轮要算哪些 token? |
| PyTorch / torch_npu / TorchAir | 算子分发、成图、后端适配和图优化 | 能否复用一段执行过程? |
| 算子库 / kernel | 算法实现、tiling、workspace 与 kernel 选择 | 一个算子怎么分块、怎么搬数据? |
| Runtime | 管理 device/context、stream/event、内存、任务与运行实例 | 在哪个流提交什么任务?何时可复用资源? |
| Driver | 设备资源、底层队列、内存映射与硬件交互等 | 任务怎样进入设备可消费的队列? |
| 设备调度机制 | 按任务与依赖驱动执行单元 | 哪项任务可以启动? |
| AI Core 等执行单元 | 执行计算与搬运 | 算力、带宽和片上容量是否够用? |
3.2 Stream、SQ、CQ:从软件顺序到硬件任务
- Stream:软件层面的有序任务流。跨流依赖需要 event 等机制表达,多开 stream 并不自动产生有效并行。
- SQ(Submission Queue):承载待提交任务描述的队列,SQE 是其中的条目。
- CQ(Completion Queue):用于完成或异常等状态上报,具体行为依实现而定。CQE 不承载模型输出 Tensor。
- SQ(SQ Entry):一次任务的描述,包含任务类型和所需的信息。
- Event / 同步接口:表达依赖或确认执行进度。异步 API 返回不能直接视为计算完成。
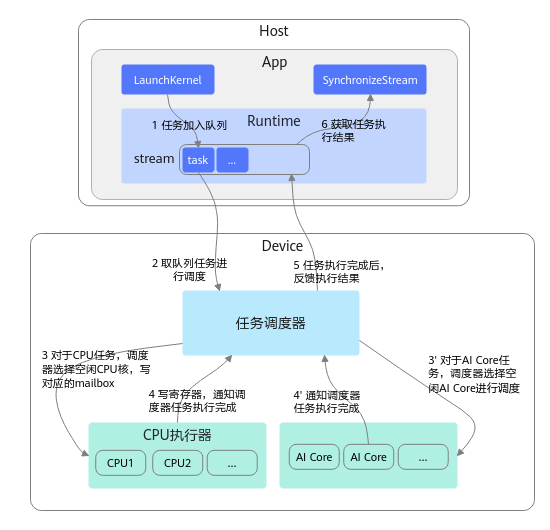
图片来源:Runtime quick start 原图(旧快照,见附录来源说明)。沿图理解:Host 调用 LaunchKernel,Runtime 将任务加入 stream,设备调度器选择执行资源,任务完成后反馈状态,Host 可通过 SynchronizeStream 等待完成。图中未单独展开 Driver,Driver 的职责结合上表理解。分层说明依据:Runtime 架构(旧快照,见附录来源说明)。
错误的一一对应:算子 = kernel、kernel = SQE、任务 = CQE。一个算子可能展开成多个 kernel 和辅助任务,一些实现中一个 Task 可占多个 SQE。当前 runtime 文档中的部分实现也不会为每个正常任务返回 CQE。
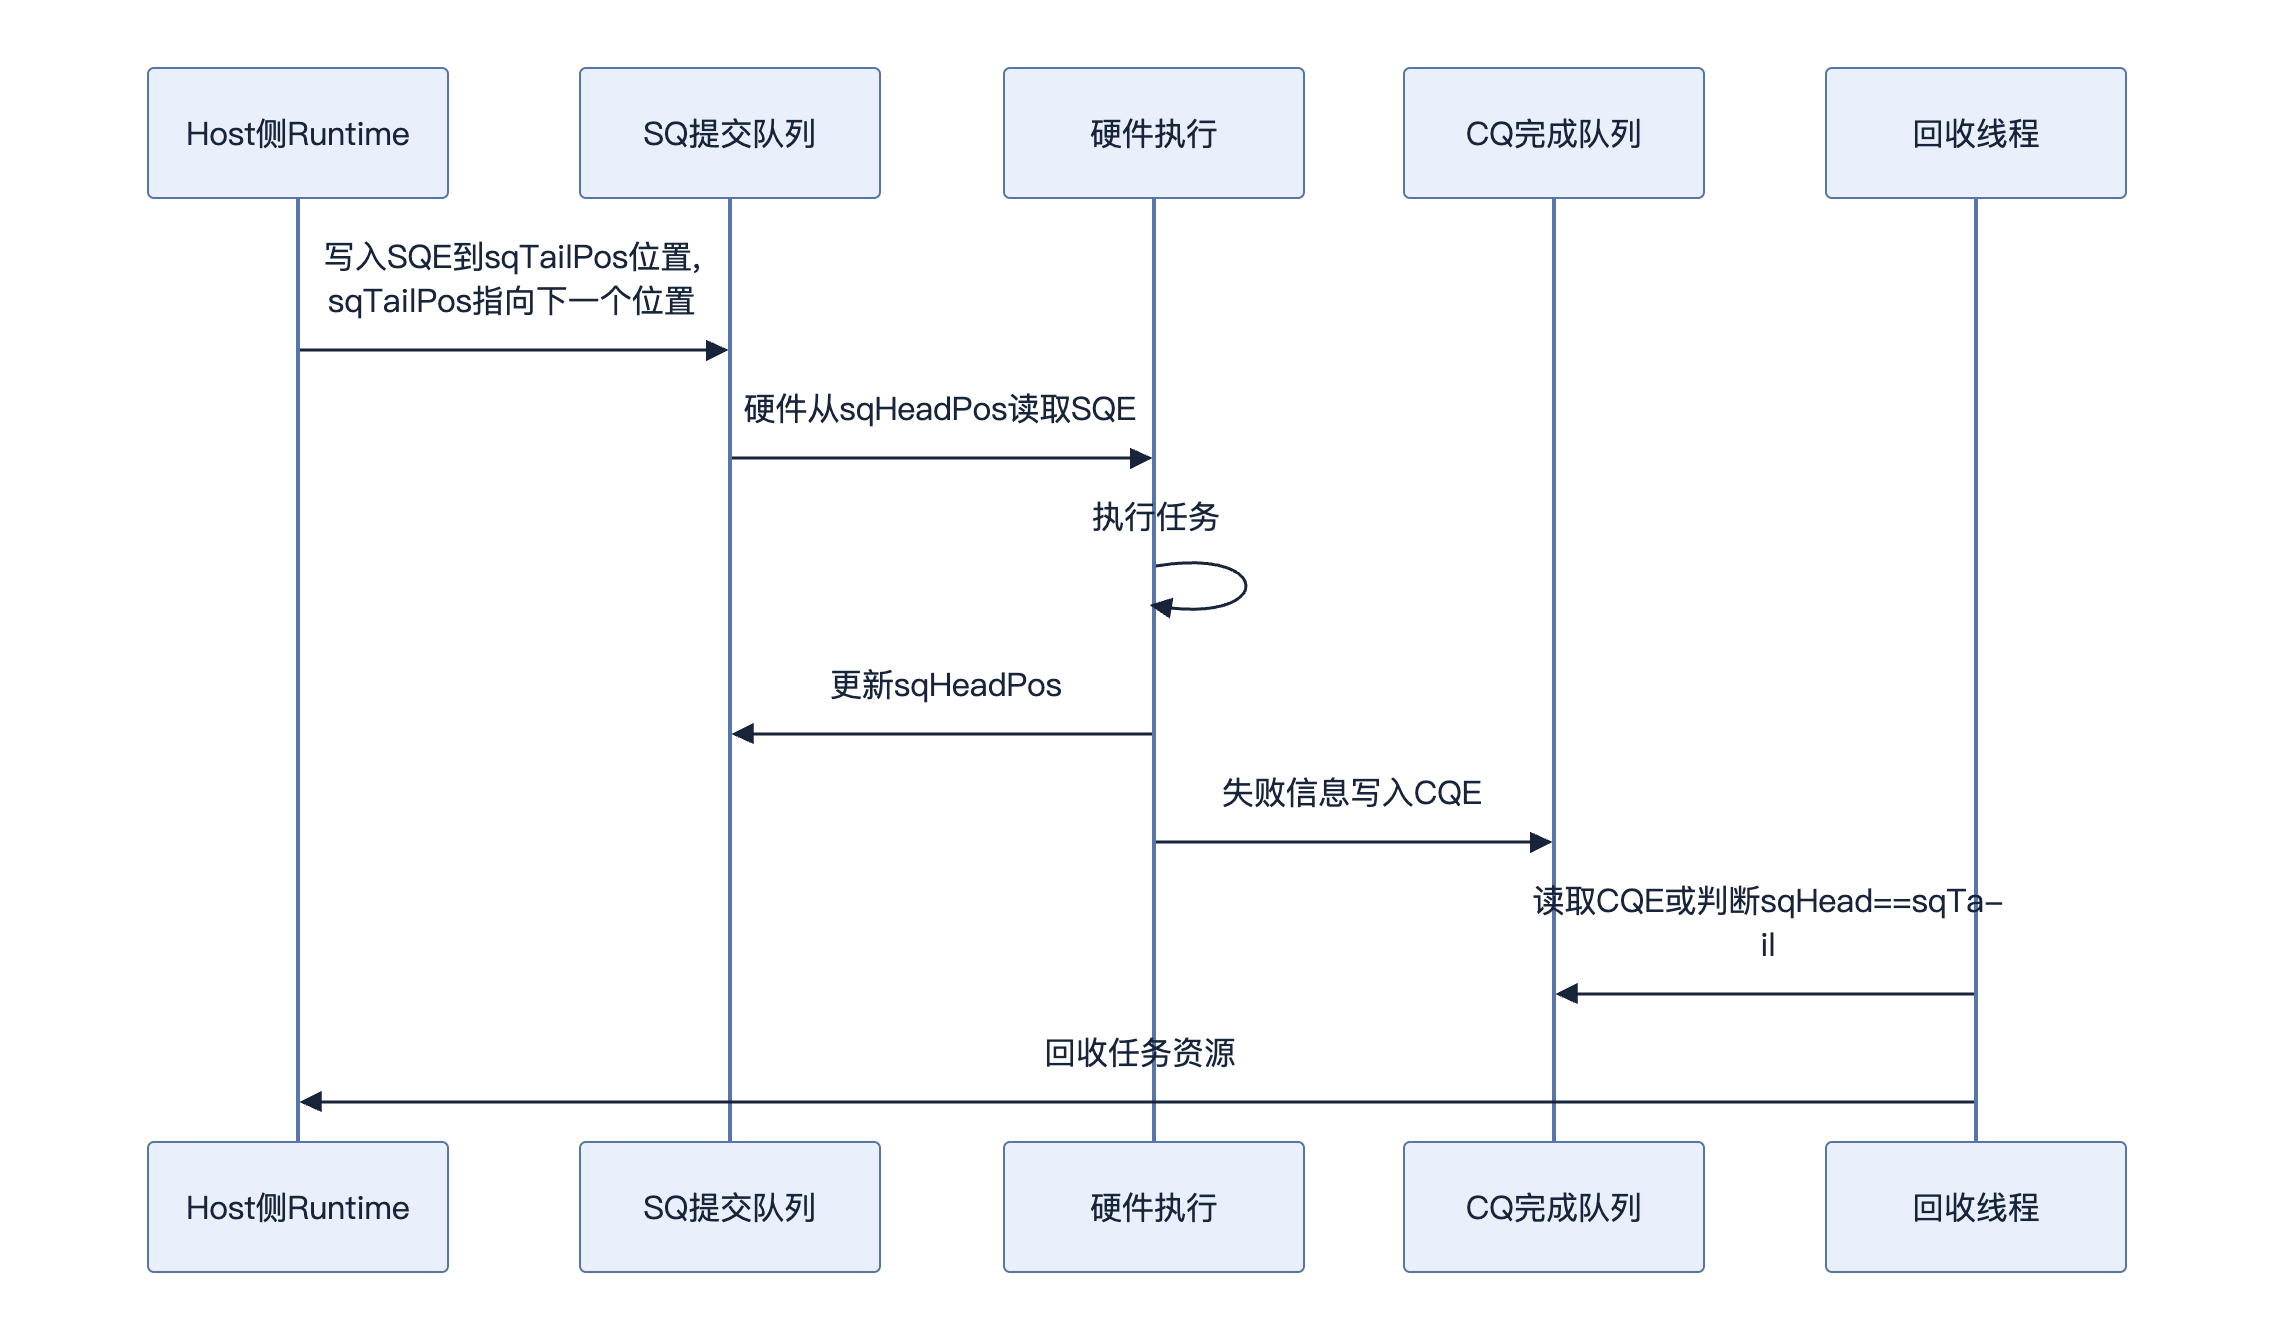
图源:Stream 的 SQ/CQ 管理(旧快照,见附录来源说明),直接复制 Mermaid 源码。这张图描述源文档对应实现的回收流程,不代表所有平台都会为正常任务产生 CQE。补充依据:Task 设计(旧快照,见附录来源说明)。
3.3 SQE 中会填什么?
单算子类 SQE 描述“执行哪个 kernel、参数在哪里”;条件算子类 SQE 通过设备侧控制指令描述“先激活哪些下沉流、满足条件后如何切换、何时停用流或结束控制过程”。 下面分别看 Eager 单算子计算任务与图模式控制任务。图中实际执行计算的任务仍然使用 kernel SQE,两类 SQE 并不是 Eager / 图模式各自独占的格式。
本节以 cann/runtime 的 STARS 实现为例;字段采用源码拼写。不同设备代际的 SQE 布局可能不同。
① 单算子(Eager 模式):kernel SQE 的关键字段
| 关注项 | 源码字段 / 对应对象 | 帮助理解的含义 |
|---|---|---|
| 任务 ID 与所属流 | header.task_id、header.rt_stream_id |
标识这次 Runtime 任务及其所属流。这里的 task ID 不是模型里算子的固定编号;一个算子也可能产生多个任务 |
| 任务类型与分核 | header.type、header.block_dim |
描述任务类型及执行的 block 数;具体计算类型还可能由 FFTS 相关字段进一步区分 |
pcAddr:执行入口 |
pc_addr_low / pcAddrHigh |
保存设备侧 kernel 入口地址的低位 / 高位,告诉执行单元从哪里开始取指令;构造 SQE 时来自 aicTaskInfo->funcAddr |
paramAddr:参数区地址 |
paramAddrLow / param_addr_high |
指向 kernel 参数区,构造时来自 aicTaskInfo->comm.args;参数按 kernel ABI 提供输入 / 输出地址、workspace、tiling 等信息 |
KernelBinaryAddr:二进制加载地址 |
对应 Program::GetBinAlignBaseAddr() 取得的设备侧基址,不是这里独立的 SQE 成员 |
Kernel::GetFunctionDevAddr() 用二进制对齐基址加函数偏移得到入口,即 pcAddr = programBinAlignBaseAddr + offset1_。SQE 保存的是解析后的入口地址,不能把二进制基址与入口当成两个必有的独立字段 |
| 调度与栈配置 | kernel_credit、schem、stackPhyBaseLow / stackPhyBaseHigh |
提供执行调度、超时相关 credit 与栈地址等控制信息,具体编码依硬件定义 |
Tensor 数据和 kernel 二进制存放在设备可访问的内存中,SQE 通过地址引用它们,不把权重 Tensor 或整段 kernel 代码塞进队列。
源码依据:kernel SQE 结构(RtStarsKernelSqe / RtFftsPlusKernelSqe)、字段填充 ConstructAICoreSqeForDavinciTask()、二进制基址到入口地址 Kernel::GetFunctionDevAddr()。
② 条件算子(图模式):条件 SQE 与流控制指令
可以把它理解成一小段 RISC-V 风格、带 STARS 流控制扩展的条件指令序列。源码称其为 STARS conditional ISA,既有 load/store、算术、比较分支和 CSR 操作,也有 STREAM_ACTIVE、STREAM_GOTO 等专用操作。它用于设备侧调度控制。
短指令序列可以直接放在 SQE 中;本地的 ModelExecute、StreamActive、StreamSwitch 构造路径使用 RtStarsFunctionCallSqe:SQE 内先装入外部指令序列的地址和长度,再通过 funcCall 执行。因此,“SQE 携带控制指令”不等于整张图的全部控制逻辑都内嵌在一个 SQE 里。
| 关注项 | SQE 字段 / 指令序列中的内容 | 帮助理解的含义 |
|---|---|---|
| 这是哪类控制任务 | sqeHeader.type = RT_STARS_SQE_TYPE_COND、conds_sub_type、sqeHeader.task_id / rt_stream_id |
标明条件任务及 ModelExecute、StreamActive、StreamSwitch 等子类型,并标识任务与所属流;ModelExecute 还用 reserved1 保存 model ID |
| 控制指令放在哪里 | lhwi1 / llwi1、lhwi2 / llwi2、funcCall |
第一组将指令序列地址装入 R1,第二组将长度装入 R2,funcCall 通过 rs1 / rs2 引用它们;此构造路径的长度单位为 4 字节 |
| 先激活哪条下沉流 | ModelExecute 外部序列的 activeHeadSq;参数 headSqArrAddr / headSqArrMax;RtStarsCondOpStreamActiveR |
遍历预先准备的入口 SQ 列表,按 SQ ID 激活对应下沉流。入口流可以有多条;硬件操作数是 SQ ID,不能直接当成软件 stream ID |
| 之后按什么条件切换 | StreamSwitch 序列的 load_i、lhwi / llwi、jumpPc0、bne0 |
从 varPtr 读取条件值,与 val 按 condition 比较,决定跳到序列末尾还是进入目标流激活过程;bne0 是成员名,实际比较指令由条件生成 |
| 切换到哪里、从哪里继续 | streamActiveFc、deActiveI;label 路径的 goto_i / active_i |
StreamSwitch 在条件命中时激活 trueSqId,停用 currentSqId;label/goto 路径还可通过 sqId、sqHead 指定队列及继续执行的位置 |
| 如何停止当前流、结束这段指令 | RtStarsCondOpStreamDeActiveI;外部序列的 end / endInstr(NOP) |
DEACTIVE 停用指定流;序列按调用长度和分支执行到末尾。末尾 NOP 是空操作 / 收尾位置,本身不是“整图终止”指令 |
| 整张图何时完成 | 图尾的 EndGraph / notify 等任务与同步依赖,不是上述 SQE 的单个通用字段 | 控制序列结束后,下沉流里的计算仍可能继续。所查 STARS 非 AICPU 执行路径在图尾记录 EndGraph notify;其他路径可下发 AICPU EndGraph 任务,整图完成要结合图尾依赖与完成通知判断 |
串起来看(示意,省略队列状态检查与同步细节):
1 | |
这里的“激活—切换—完成”分布在模型执行任务、下沉流内的控制任务以及图尾任务中。ModelExecute 的控制序列返回,只表示本次启动控制过程结束,不能据此认定整张图已经执行完毕。
源码依据:条件 SQE 结构 RtStarsFunctionCallSqe、装入指令地址和长度 ConstructFunctionCallInstr()、ModelExecute SQE 构造、模型执行控制序列、StreamSwitch 控制序列与参数、StreamSwitch 指令构造、指令编码与 SQ ID / SQ head 字段、图尾完成处理 Context::ModelAddEndGraph()。
4. 图下沉与图捕获
4.1 图下沉
提前准备图中的任务、依赖与运行资源,交给设备侧执行。后续通过模型执行入口触发已准备的任务,减少 Host 逐个组织与提交任务的成本。
离线编译出的 OM 是常见部署产物,但图下沉不只存在于静态 OM 路径。在线编译或捕获也可以建立可复用的设备执行过程。
Persistent Stream 的教学模型:创建持久流,绑定模型运行实例,构建任务,结束构建,然后反复执行实例。任务执行后保留,直到清理或销毁。Persistent 流说明与示例(旧快照,见附录来源说明)
“执行时只下发一个 SQE”适合帮助形成初步直觉,更准确地说:通过模型执行任务触发已准备的任务集合。 一个模型执行 API 对应几个 SQE,是否还需要参数刷新或同步任务,应以平台实现与 trace 为准。
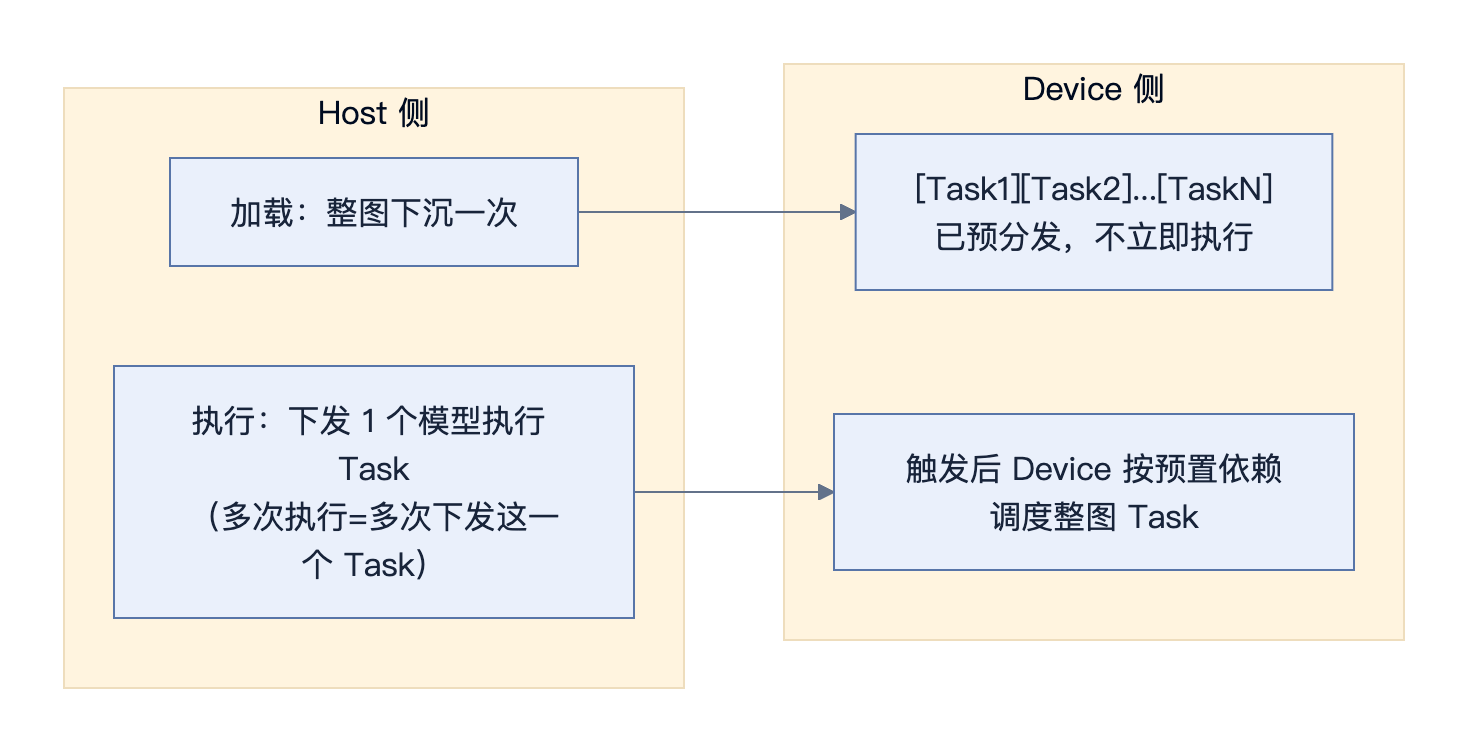
图源:GE 图下沉 Mermaid。
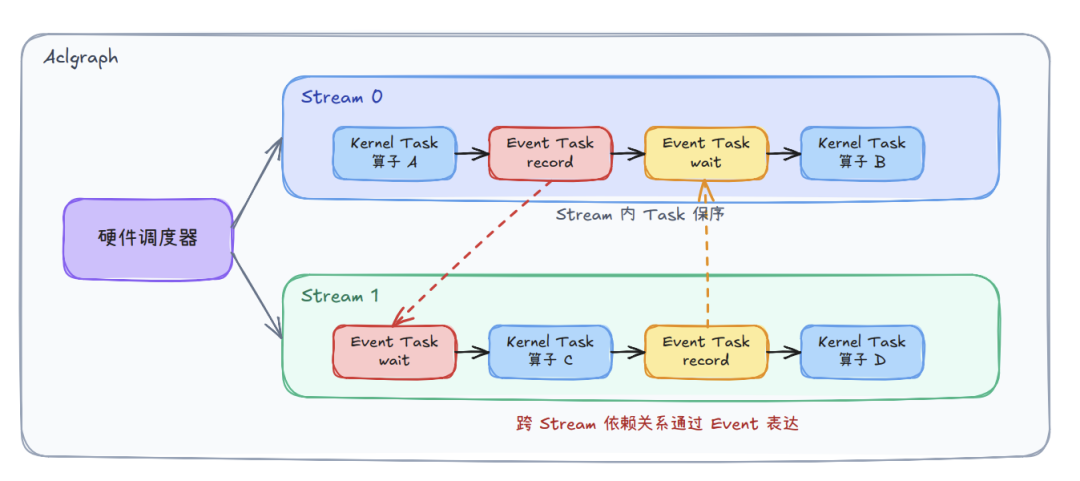
4.2 ACLGraph 捕获的是运行任务
以下为 Runtime 接口生命周期示意:
1 | |
Capture 区间保留了类似 eager 的调用形式,但任务不会像正常 eager 一样立即执行。该接口将任务记录到模型实例中,在 execute 时运行。CANN CaptureBegin 说明
区分两个“捕获”:Dynamo 提取 FX 运算图,ACLGraph 捕获 Runtime 任务及依赖。 它们位于不同层,直接使用 Runtime 捕获接口也不要求先走 Dynamo。
4.3 IO数据变化,但地址可以不变
做图下次、图捕获,一个非常大的优化点上提前申请、安排的好权重、每个算子IO、算子Binary的地址空间。
| 资源 | 复用时要理解的约束 |
|---|---|
| 权重与常驻 KV buffer | 保持有效生命周期。地址或布局变化时,要满足更新机制或重新准备实例 |
| 输入 / 输出 | 可写入稳定 buffer,也可能由后端支持地址更新。不能假定输入地址永远不变或任意变化都安全 |
| 激活 / workspace | 通过内存规划、内存池等满足任务需要。复用前确认旧使用者已完成 |
| kernel 二进制与参数 | 执行时需要有效入口与参数,部分参数与 tiling 支持受控刷新 |
“所有内存都预申请、执行时尽量不动态申请”。在重复执行的关键路径中减少分配与地址变化,实际约束由后端、内存池与更新 API 决定。
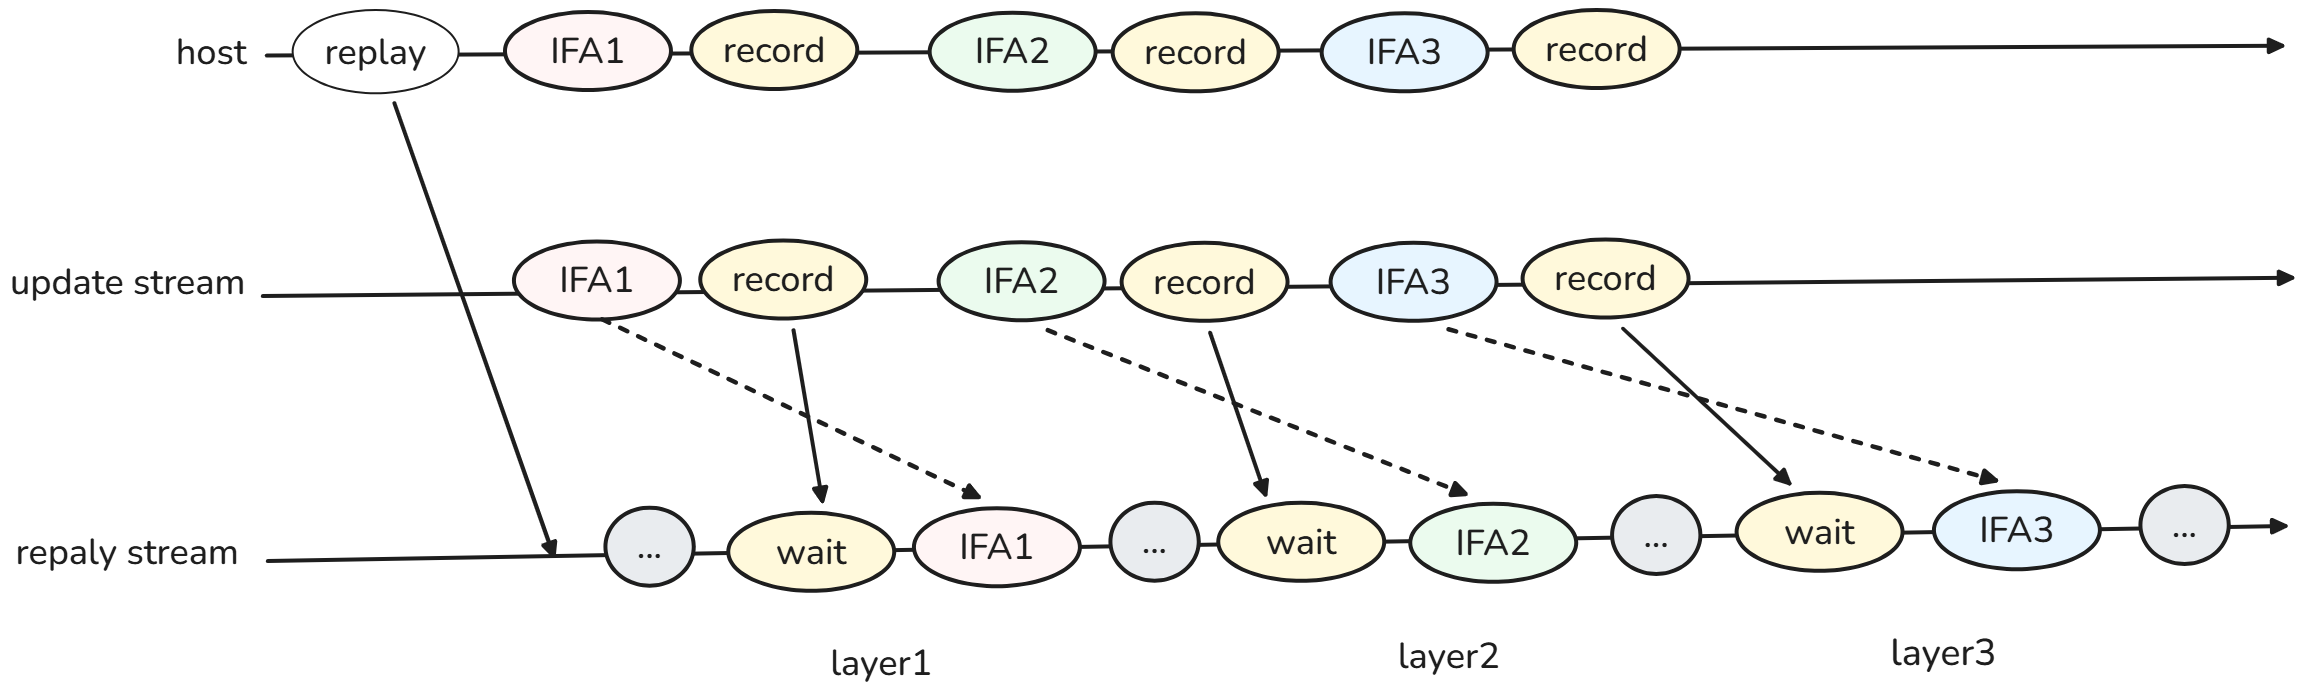
来源:npugraph_ex 图模式优化:Host tiling 参数刷新。此图展示受控参数更新与同步,说明 replay 仍可能有准备工作。
5. 图编译
5.1 一张计算图不等于一条算子队列
用 y = SiLU(x @ W + b) + residual 贯穿本节。假设这是推理计算:W、b 固定,x、residual 每轮变化,中间结果不被其他节点使用。
| Tensor | Shape | 在图中的角色 |
|---|---|---|
x |
[M,K] |
本轮输入,M 可理解为本次参与计算的 token 数 |
W |
[K,N] |
权重 |
b |
[N] |
bias,沿 M 维广播 |
residual |
[M,N] |
残差输入 |
t0、t1、t2、y |
[M,N] |
三个中间结果与最终输出 |
先按数学运算展开,得到一张未融合的逻辑图:
1 | |
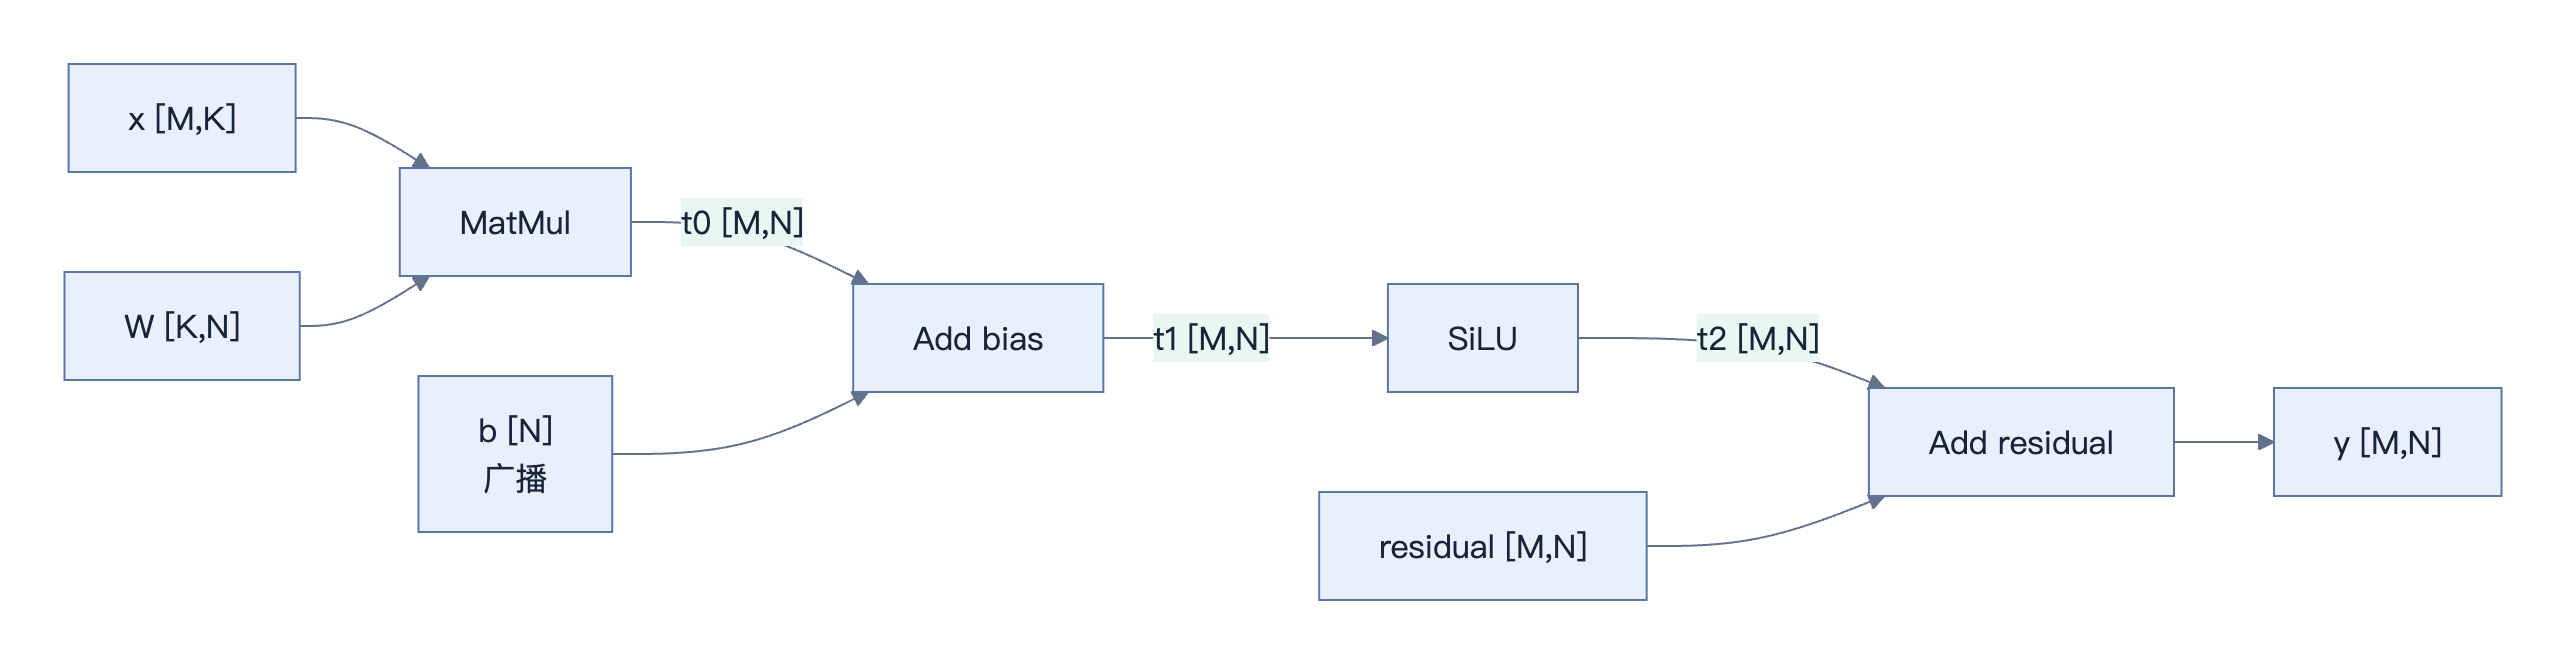
这张图除了运算顺序,还包含 shape、dtype、布局、广播方式,以及 Tensor 的使用关系。编译器由此知道:t0、t1、t2 都只有一个消费者,可以尝试消除它们的独立存储;b 不必真的扩成 [M,N];最后的 Add 必须等 t2 和 residual 都就绪。
这里有 4 个逻辑计算节点,但不能据此断言最终有 4 个 kernel 或 4 个 SQE。SiLU 可能被分解,多个节点也可能被融合;运行任务图是编译器结合算子实现和硬件约束生成的另一层表示。
图为本节表达式的教学示意。相关概念见 GE 图编译课程。
5.2 编译过程需要确定什么?
| 工作 | 在这个例子中具体做什么 | 产物或影响 |
|---|---|---|
| InferShape | 检查 MatMul 的 K 维相同,推导输出 [M,N];确认 b[N] 可广播、residual 可相加 |
得到中间结果大小与 shape 约束;M 动态时保留相应符号信息 |
| dtype / Format 推导 | 确定乘加累加精度、中间结果 dtype,以及 MatMul 输出能否直接供 SiLU 使用 | 决定 kernel 适配与必要的 Cast / TransData;融合时也要满足数值精度要求 |
| 图变换 | 尝试将 MatMul 与 bias 相加融合,将 SiLU 与残差相加融合 | 得到下面的两阶段候选图,减少独立任务与中间结果 |
| Tiling / kernel 选择 | 根据 M、K、N、dtype 与布局选择矩阵分块、分核和向量处理方式 | 例如 M 很小与 M 很大时可能选择不同实现;确定 workspace 与运行参数 |
| 内存规划 | 计算中间结果生命周期,决定哪些结果无需落地、哪些存储可复用 | 为输入、输出、中间结果和 workspace 安排 buffer |
| 调度与任务生成 | 保持 MatMul 到后续逐元素计算的依赖,等待 residual 就绪,再生成计算与同步任务 | 得到 stream、依赖、任务及参数,交由 Runtime 执行 |
这是教学分解,并非所有后端固定的一遍式流水线。动态输入下,一部分 shape、tiling 或参数工作可能留在运行期。Ascend IR 是 GE 路径使用的中间表示;npugraph_ex 主要围绕 FX 图优化与 ACLGraph 执行展开。
5.3 常见优化:逐项作用到这张图上
| 技术 | 对这个例子怎么做 | 真正省了什么、什么条件下才成立 |
|---|---|---|
| 常量折叠 | 原图没有可直接折叠的计算节点:即使 W、b 固定,x @ W + b 仍依赖动态 x。若实际图中还有仅依赖固定 b 的 Cast,可提前计算 |
消除常量子图的重复计算;不能提前算出本轮 MatMul 或 SiLU |
| 冗余消除 | 原始四节点没有明显冗余。若前后端适配引入同 dtype 的无效 Cast,或确实无须搬数据且不影响语义的 View,可消除或只保留元数据 | 避免多余转换;不能任意删除有精度变化的 Cast,也不能删除改变后续索引语义的 View |
| 算子融合 | 候选:MatMul + Add bias → MatMulBias,SiLU + Add residual → SiLUAdd |
在支持的 shape、dtype、布局下,可能将 4 个计算阶段缩成 2 个,避免 t0、t2 的独立 GM 写入与读回;具体见下表 |
| 布局优化 | 为 MatMul 选择合适的权重与输出格式,让后续融合 kernel 尽量直接消费该输出;b 用广播寻址 | 减少 TransData 和不必要的广播物化。若后续 kernel 不支持该格式,则要比较格式转换成本与 MatMul 的收益 |
| 内存复用 / 安全原地化 | 未融合时,t0 在 bias Add 完成后不再使用,其 buffer 可供后续 t2 使用;若 kernel 支持且无别名冲突,逐元素计算还可考虑原地写入 | 降低存储需求;复用同一地址不会自动消除 GM 读写。不能覆盖仍有其他消费者的 residual 或输入 |
| 权重冻结与准备结果复用 | 若 MatMul 需要 W 的格式转换或打包,且 W 不变,在准备阶段完成并复用;需要时同样准备 b | 省去每轮权重准备。W 更新后要重新准备;这是准备结果复用,不是把 x @ W 常量折叠 |
| 多流并行 | 本图的 4 个计算节点是一条依赖链,拆到多个 stream 不能让它们任意并行。若扩展示例为 residual = g(x),且 g 与 MatMul 分支独立,才可尝试两分支并行并在最终 Add 汇合 |
只有存在独立工作且设备资源允许时才可能缩短关键路径;新增同步也有成本 |
| 静态 kernel 编译 | 当 M、K、N、dtype 和布局固定时,对适用 kernel 专门化;M 有少数常见值时可为不同档位准备实现 | 减少通用分支、部分 shape 与标量计算;编译与缓存成本会上升,也不能保证所有 shape 都由同一实现覆盖 |
把融合前后画出来: 下图是候选执行方案,不表示某个后端一定会自动实现这两种融合。
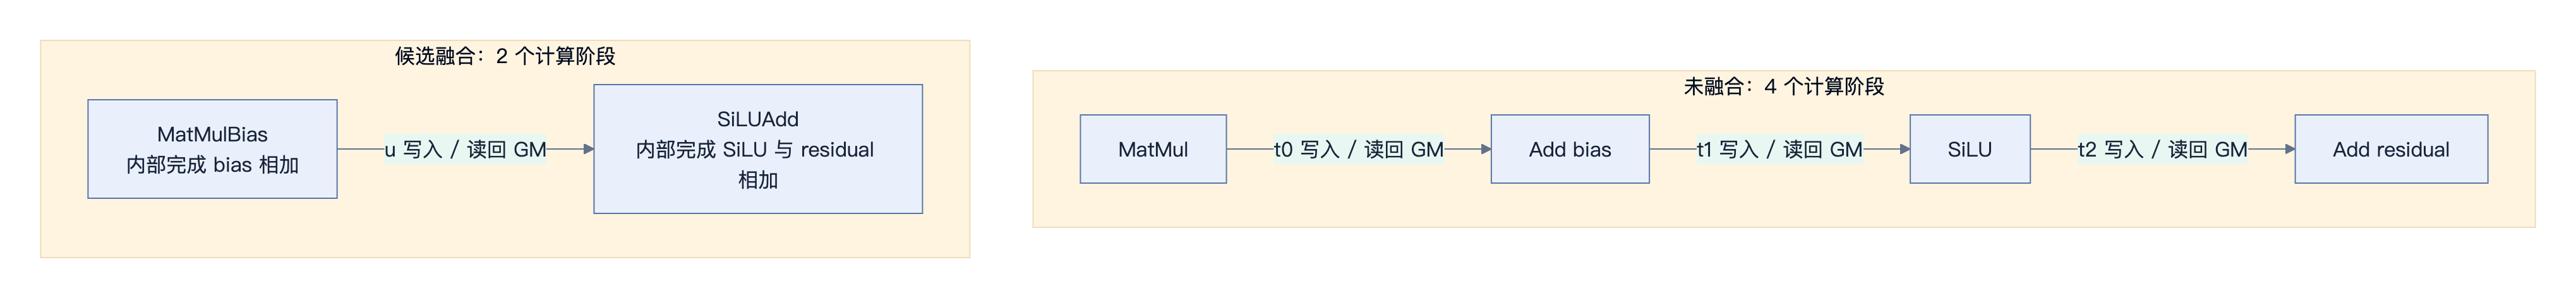
对应计算仍是 u = x @ W + b、y = SiLU(u) + residual。这里的 MatMulBias、SiLUAdd 是示意名称,不是接口名。SiLU 是非线性的,不能把 residual 移到 SiLU 前面;融合还需符合要求的舍入、累加精度和误差容限。
假设每个未融合阶段各用一个 kernel,每个中间 Tensor 都完整写入 GM 并被下一阶段读一次,且每元素占 s 字节:
| 候选方案 | 计算 kernel 数(假设) | 完整落入 GM 的中间结果 | 仅这些中间结果的逻辑读写量 |
|---|---|---|---|
| 四阶段独立执行 | 4 | t0、t1、t2 | 6 × M × N × s 字节 |
| MatMulBias + SiLUAdd | 2 | u | 2 × M × N × s 字节 |
| 整段融合,且中间结果均留在片上 | 1 | 无 | 0;不含实现可能需要的 workspace / spill |
两阶段方案在上述假设下少了两次计算 kernel 启动,并少了 4 × M × N × s 字节的中间结果逻辑读写。例如 M=128、N=4096、s=2 时,这部分从 6 MiB 降到 2 MiB。统计不含 x、W、b、residual 的读取、y 的写入与 workspace;缓存命中、分块及实际 kernel 实现也会改变物理访存量,所以这不是实测带宽或加速比。
整段融合需要适用的实现、分块方式以及 Cube / Vector 协作。它可能减少更多中间结果搬运,也可能因片上存储压力、同步或并行度下降变慢。编译器需要在这些候选方案中选择,不能仅凭 kernel 数最少来判断最优。
最终落成什么执行计划? 以两阶段候选为例,准备阶段选好两个 kernel、tiling、权重格式与所需 buffer;运行时先执行 MatMulBias 写出 u,再在 u 和 residual 就绪后执行 SiLUAdd 写出 y。若 residual 来自其他流,计划中还要包含相应等待。计算之外也可能有转换、拷贝与同步任务,不能把“两阶段”直接等同于“整图只有两个 SQE”。
验证时看三个证据:编译前后图中哪些节点被融合或消除;kernel trace 是否减少启动、转换与等待;数值检查通过后,端到端耗时和峰值内存是否改善。图回放还可复用这份执行计划、减少 Host 反复组织任务的开销;它与本节改变计算和访存安排的优化可以叠加。
功能背景:npugraph_ex 基础功能、静态 kernel 编译、GE 多流。本节具体融合图和流量计算为教学推演,实际生成结果需在目标后端与设备上验证。
6. 编译后端
TorchAir(Torch Ascend Intermediate Representation)的定位是 torch_npu 配套的图模式能力扩展和 torch.compile 后端接入层。它不是另一套 NPU 算子库,也不是 GE 本身:torch_npu 负责 PyTorch Tensor、算子与 NPU 设备接入;TorchDynamo 从 Python forward 中提取 FX Graph;TorchAir 接收这张图,做昇腾相关的图优化、转换与执行接入;更下层的 GE、Runtime 和算子实现再完成编译、下发与执行。
TorchDynamo 是 torch.compile 的前端图捕获组件,它在 Python 程序运行时分析字节码,将其中可编译的 Tensor 计算提取为 FX Graph,再交给后端处理。
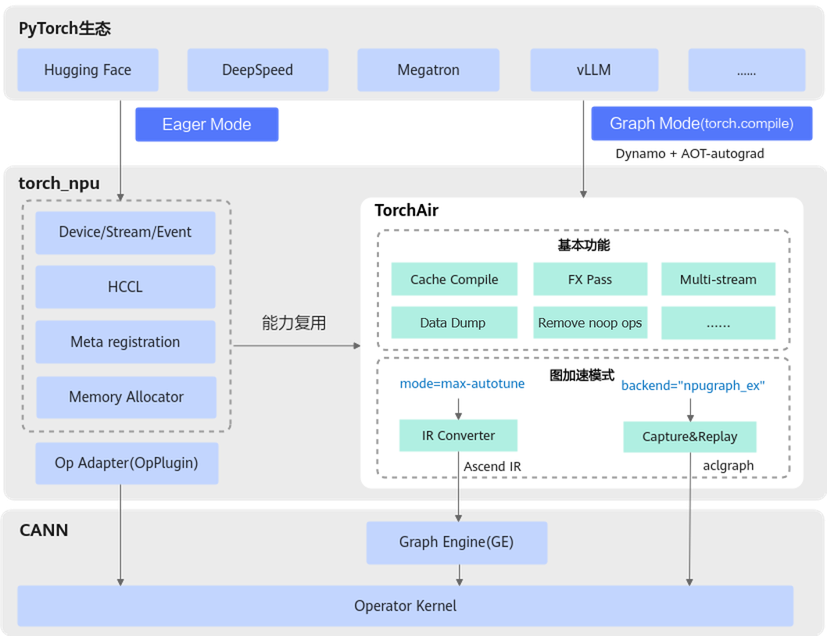
来源:TorchAir 总览。
读这张图时可以先抓住一条主链路:
1 | |
把 TorchAir 简化成“GE 的 Python API”,或把 npugraph_ex 简化成“一个 Runtime capture 开关”,都不够准确。特别是 npugraph_ex,除了 ACLGraph 捕获回放,还包含 FX Pass、内存优化、多流等图级能力。
| 名称 | 所处层次 | 本次分享中的定位 |
|---|---|---|
| ACLGraph / ModelRI | Runtime 捕获与执行能力 | 保存、更新和执行一组任务 |
npugraphs |
torch_npu 相关图后端名称 | 基础捕获回放路径的背景知识,具体可用接口看安装版本 |
npugraph_ex |
TorchAir 的 torch.compile 后端 |
FX 优化与 ACLGraph capture / replay,当前 recipe 有直接分支 |
ge_graph |
cann-recipes-infer 的执行模式配置值 | 由 recipe 选择 TorchAir 的 GE 路径,不是直接传给 torch.compile 的字符串后端名 |
torchair.get_npu_backend() |
获取可传给 torch.compile 的后端 callable |
当前参考版本默认配置走 GE 路径,TorchAir 将 FX 转为 Ascend IR,交由 GE 编译执行 |
这几层配置入口也不要混用:
| 配置入口 | 归属层 | 它回答的问题 |
|---|---|---|
exe_mode: ge_graph |
recipe | 业务框架选择哪条执行路径 |
torch.compile(..., backend=...) |
PyTorch | Dynamo 捕获的 FX Graph 交给哪个后端 |
CompilerConfig.mode |
TorchAir | TorchAir 后端内部采用哪种编译 / 执行模式 |
ge_graph 配置值与 TorchAir 后端对象
在 recipe 中设置 exe_mode: ge_graph,框架会调用 TorchAir 获取后端对象,再将它作为 backend 参数传给 torch.compile。不要把 recipe 配置直接写成 torch.compile(model, backend="ge_graph")。
标准调用方式如下,假设 model 已准备好:
1 | |
TorchAir 在这条路径中承担适配与编译接入工作:接收 PyTorch 的 FX 计算图,将其转换为 Ascend IR,再交给 GE 完成图编译与优化,最终经 Runtime 等执行层下发到昇腾硬件。GE 是这条 TorchAir 后端路径内部使用的图引擎。
当前参考版本中,torchair.get_npu_backend() 使用默认配置时走 GE 图引擎路径。 本地 CompilerConfig.mode 默认为 max-autotune;若显式修改模式,则不能继续套用这个默认结论。另一个后端 npugraph_ex 支持直接以 backend="npugraph_ex" 传入,要与 recipe 的 ge_graph 配置值区分。
依据:get_npu_backend 官方接口说明、CompilerConfig 默认值、后端实现。
图捕获与图编译可以叠加。npugraph_ex 也能做 FX Pass、内存优化等工作;GE 也需要 Runtime 执行编译结果。后端名字不能直接等同于某一类唯一的性能收益。
历史资料可能使用 acl_graph、reduce-overhead 等命名,迁移关系见 TorchAir 总览。讲解时以当前代码入口为锚点。
编译缓存与 replay 缓存
同进程 replay 复用已建立的运行实例。磁盘编译缓存复用后端明确支持持久化的编译结果,不能推导出新进程的设备地址、内存池或运行实例都可原样恢复。
recipe 原理文档把 npugraph_ex 缓存描述为可跳过 Capture,而 TorchAir npugraph_ex 缓存说明 强调缓存 Dynamo 结果,并注明跳过 JIT 与 Guards 的约束。本讲稿按后者讲解,不承诺缓存命中后完全没有 Capture 或设备初始化。实际启动阶段以对应版本实现和日志为准。
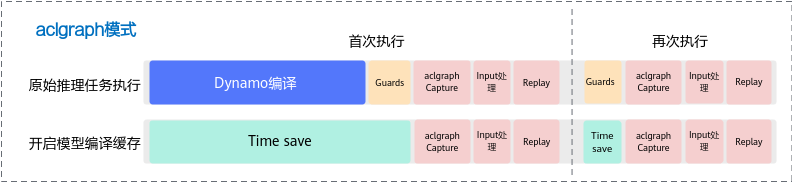
来源:TorchAir 编译缓存说明。这是原文案例的时间分布示意,不是本组实测数据。
7. 动态 shape 图
7.1 Prefill 和 Decode 是一张图吗?
同一个模型的两个阶段,不一定复用同一张执行图。 权重可以相同,但输入规格、Attention 的计算方式与执行分支不同,通常需要分别准备执行路径。
| 对比项 | Prefill | Decode |
|---|---|---|
| 本轮输入 | 一段 prompt 或一个 chunk,query 长度可变 | 普通自回归通常每条序列输入 1 个新 token |
| Attention 工作 | 处理本轮多个 token,并建立或补充 KV Cache | 新 query 读取已有 KV,并追加本轮 KV |
| 影响执行计划的变化 | prompt 长度、batch、分块方式等 | batch、有效 KV 长度、活跃请求集合等 |
| 当前 recipe executor 路径 | 走 Eager | 开启图模式后调用 compiled model |
因此,在本文的 recipe 路径中,Prefill 和 Decode 并没有共用一张编译执行图。这是一种工程选择,不代表 Prefill 不能用图:Prefill 也可以按长度分档、固定 chunk,或使用后端支持的动态 shape 编译。即使两阶段调用同一个 Python forward,也可能因为 is_prefill 等分支和输入约束形成不同编译版本。
依据:recipe 的推理分支。
7.2 Decode 图是动态图吗?
静态图,但动态 shape。
Decode 阶段,T 维度固定为 1,但是 Batch 维度 和 KVcache 维度会变化。
例如 query 使用 [B,1,H],KV 使用预分配的物理存储。B、H 和存储规格固定时,即使有效 KV 长度从 1024 增到 1025,query 与 KV 存储 Tensor 的 shape 仍可保持不变;变化的是有效长度、位置与索引等数据。
| Decode 中的变化 | 是否必然改变 Tensor shape? | 对图执行的影响 |
|---|---|---|
| token id、position id 更新 | 否 | 通常更新输入 buffer 内容即可 |
| 有效 KV 长度增加 | 否,预分配存储可保持原 shape | Attention 需要读取新长度;适用实现还可能需要刷新 tiling |
| batch 从 8 变为 6 | 若直接改变 B,则会;若填充到固定档位,则可保持不变 | 可能复用动态编译图、选择已有档位,或产生新的编译 / capture |
Decode 可以采用静态 shape 图,也可以采用动态 shape 图;一张动态编译图还可能对应多份具体 shape 的回放实例。 普通 Decode 的 query 长度为 1,只固定了其中一个维度;MTP / speculative decoding 的验证阶段还可能一次处理多个 token。
对应本仓配置,npugraph_ex 将 enable_dynamic_graph 传给编译入口的 dynamic 参数;当前 GE recipe 分支固定使用 dynamic=False。这是该封装的选择,不代表 GE 整体没有动态 shape 能力。依据:编译入口、TorchAir 动 / 静态图概念。
7.3 动态 shape 图如何编译?
编译器把允许变化的维度表示成符号,先编译可复用的计算关系,再由运行时补充具体尺寸与执行参数。 这不要求把所有维度都设为动态:例如 Decode 的 B 可变,而单 token 维度 1、hidden size H 和权重维度可以固定。
结合第 5 节的表达式,若输入为 x[B,1,H]、权重为 W[H,D],编译器可保留 B 为符号,推导 x @ W 的输出为 [B,1,D],后续 bias、SiLU 和 residual Add 沿用这一形状关系。
| 步骤 | 编译器 / 运行时做什么 | 本例中得到什么 |
|---|---|---|
| 1. 表达动态维度 | 在捕获与 shape 推导中保留需要泛化的符号维度 | 用 B 表示可变 batch,保留 H、D 及必要约束 |
| 2. 生成复用条件 | 记录 shape 关系、dtype、布局和所走分支等条件;普通 torch.compile 路径用 Guards 检查适用性 |
换一个 B 后仍要满足矩阵维度匹配、残差可相加等要求 |
| 3. 优化并选择实现 | 对符号图做适用的融合与布局优化;后端选择支持动态尺寸的实现,或为部分情况生成专门版本 | 可以保留 MatMul 与后续融合的结构,不必为每个 B 重做全部图级工作 |
| 4. 准备具体执行 | 获得本轮 B,完成必要的 shape、tiling、workspace 与 buffer 准备;可复用的准备结果继续复用 | 为这次输入确定具体分块、地址与任务参数 |
| 5. 复用或生成新版本 | 满足约束则复用;不满足时可能重新编译。回放实例不适用时,还可能需要新 capture | “编译图命中”和“回放实例命中”要分别判断 |
dynamic=True 会尝试动态 shape 编译,但不是“任意尺寸、任意分支都只编译一次”的保证;有些维度仍会被专门化。PyTorch 动态 shape 说明
以本文的 npugraph_ex 路径为例,可以这样区分两层复用:
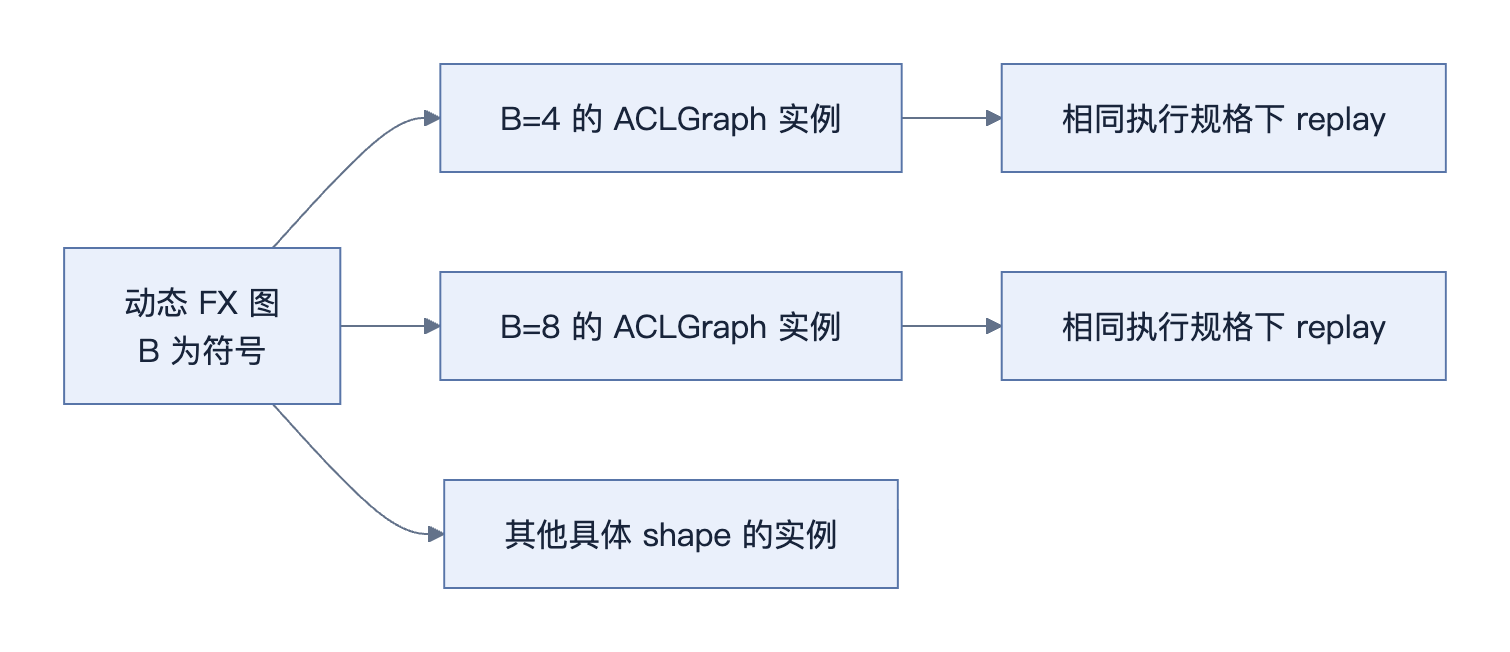
图为教学示意。所参考的 npugraph_ex 实现可从同一张动态 FX 图捕获多个具体 shape 的 ACLGraph。因此 FX 图没有重编译,不代表没有发生新的 Runtime capture。另一种策略是分档:例如为 batch 1、2、4、8、16 准备实例,实际 batch 6 填充到 8,正确处理 mask、KV 写入和无效请求输出;这用额外计算换取实例复用,并非本仓默认档位。依据:npugraph_ex 内存复用说明。
那不断增长的 KV Cache 怎么适配? 可以把“存储容量”和“有效计算长度”分开:
- 稳定存储。 预先分配连续 KV buffer 或物理 block 池。Paged KV Cache 通过
block_table/slot_mapping将逻辑 token 映射到物理块;从已有池中分配 block,不必每步都向设备 allocator 申请一块更大的 Tensor。 - 更新本轮数据。 写入新增 KV,更新有效长度、位置与映射。要复用同一份回放实例,这些输入的规格、地址和生命周期仍需满足该实例的要求。
- 更新需要变化的执行参数。 若 Attention 的 tiling 依赖有效 KV 长度,受支持的图执行路径可在该算子执行前刷新参数,并用同步保证更新完成后再执行;不能仅因 Tensor shape 未变就沿用已经不适用的 tiling。
例如固定 B、预留足够 KV 容量和索引表空间后,从第 1024 步到第 1025 步可能只需更新长度、索引与相关参数,无须因为长度加一就重新编译。若超出预留容量、输入 shape 改变,或算子不支持所需更新,则要调整执行方案。Paged Attention 有助于稳定存储,但它不是图模式的必要条件,也不能代替动态编译与参数更新。
依据:KV Cache 管理设计、npugraph_ex 的 Host tiling 参数刷新。
8. 用一次实验把整条链路串起来
本组实测于 2026-09-29 完成,参考 cann-learning-hub/tutorials/llm_inference/qwen3_8b/07_npu_graph_optimization.ipynb,在 Ascend A3 环境对比 Qwen3-8B 的 Eager、TorchAir GE Graph 和 NPU Graph EX。数据来自 完整实验记录:每种模式运行 3 个独立新进程,以中位数作为主结果,方括号给出三轮最小值和最大值。
8.1 对比变量固定
| 维度 | 本次配置 |
|---|---|
| 模型与精度 | ModelScope Qwen/Qwen3-8B 原始 BF16 权重 |
| 硬件 | Ascend A3 配置;环境报告 Ascend910 / SoC ascend910_9391,单卡 64 GiB HBM |
| 并行与负载 | TP=1、batch=1;固定 prompt 实际 50 token,返回 64 token,关闭 thinking |
| 软件 | PyTorch 2.10.0+cpu、torch_npu 2.10.0.post4、CANN 9.1.0、Transformers 5.14.1、Python 3.12 |
| 对比方法 | 使用 notebook 的 recipe 和同一份 YAML,三组仅改 exe_mode |
| 隔离图模式本身 | 关闭 profiler、编译缓存、static kernel、显式 RMSNorm / AddRMSNorm 融合和权重预取 |
| 图覆盖范围 | 两个图后端都只编译 Decode,Prefill 仍走 Eager |
| 实际任务队列配置 | TASK_QUEUE_ENABLE:Eager / GE Graph 为 2,NPU Graph EX 为 1 |
正式生成前沿用 recipe 的一次 Prefill 和一次 Decode 预热,图后端在此触发编译、capture 等准备。正式生成中,每个 forward 计时都覆盖异步执行的完成边界;未开 profiler,避免诊断开销污染主结果。
8.2 稳态性能:图后端主要加速 Decode
| 模式 | TTFT ms | TPOT ms/token | Decode 平均时延 ms/步 | Forward 吞吐 token/s | 实际生成吞吐 token/s | Forward 相对 Eager |
|---|---|---|---|---|---|---|
| Eager(不开图) | 77.66 [77.00, 80.16] | 63.20 [62.88, 63.22] | 63.18 [62.86, 63.18] | 15.53 [15.53, 15.60] | 13.61 [13.59, 13.64] | 1.00× |
| TorchAir GE Graph | 74.91 [69.46, 75.97] | 17.41 [17.13, 17.87] | 17.40 [17.13, 17.85] | 53.81 [52.57, 54.91] | 40.21 [39.62, 40.96] | 3.46× |
| NPU Graph EX | 82.03 [82.01, 86.00] | 23.86 [23.84, 23.86] | 23.86 [23.84, 23.86] | 39.77 [39.70, 39.78] | 29.38 [29.29, 29.82] | 2.56× |
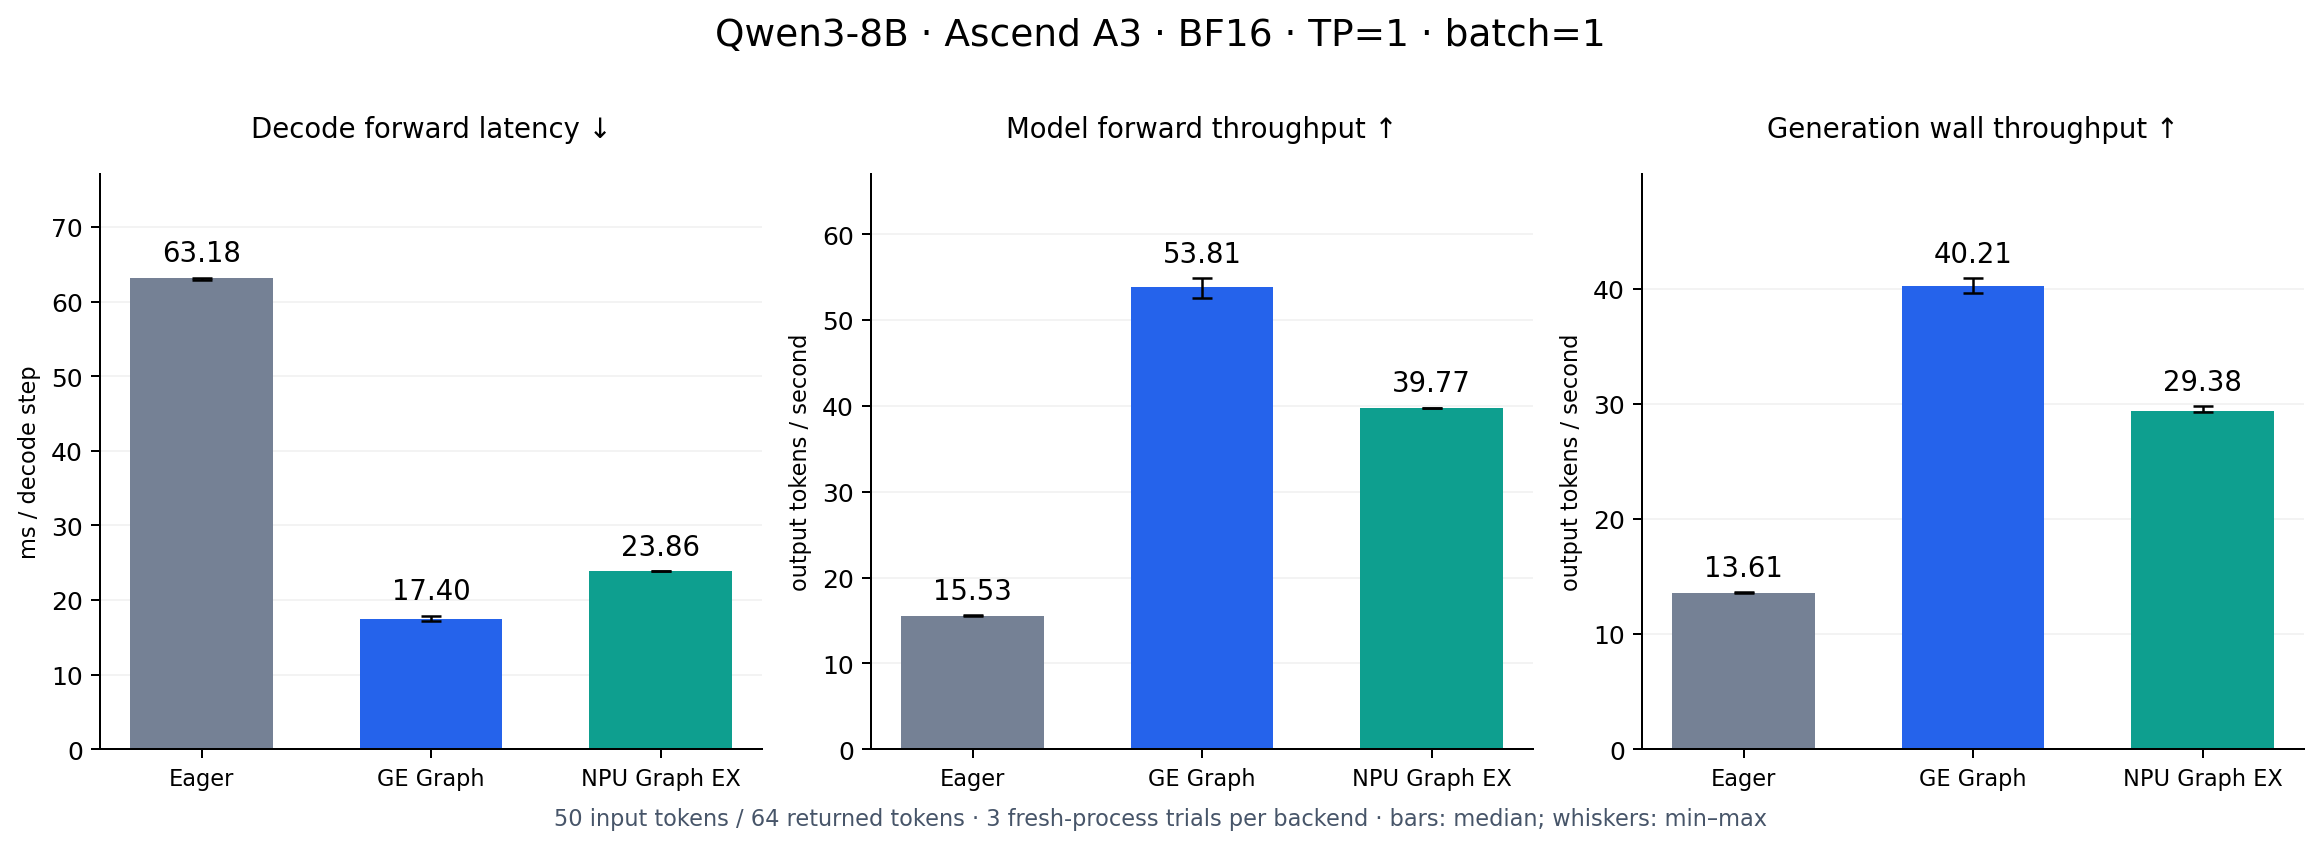
表中的 TTFT 和 TPOT 是根据逐步 forward 时间补充的模型执行代理指标,不是服务端网络指标:
- Forward TTFT 代理值取 Prefill forward 时间。它不包含请求排队、网络、tokenization、采样和文本解码;三组 Prefill 都走 Eager,所以图后端没有呈现 TTFT 收益。
- 这个 offline scheduler 的第 1 个输出 token 由 Prefill 产生,随后 63 个 Decode 步产生其余有效 token。Forward TPOT 代理值取这 63 个步骤的平均;实验日志还有第 64 个 Decode 步,但其产生的 token 不进入最终返回的 64 token。
- 为与实验主报表保持一致,“Decode 平均时延”仍按全部 64 个 Decode 步计算。
Forward 吞吐 = 64 / (Prefill + 64 个 Decode forward)。 - “实际生成吞吐”为
64 / llm.generate() wall time,还包含调度、采样、逐步日志和最终文本解码,但不包含模型加载、预热和首次编译。因此 GE Graph 和 NPU Graph EX 的实际生成吞吐分别是 Eager 的 2.96× 和 2.16×,低于只看 forward 的 3.46× 和 2.56×。
这组数据把前文的执行链路串了起来:exe_mode 选择后端 → 预热触发编译 / capture → 正式 Prefill 仍用 Eager → 重复 Decode 复用图执行结果 → forward 的收益在 scheduler 等额外开销后折损成实际生成收益。
8.3 稳态更快,代价是首次启动耗时
| 模式 | Decode 总时间 s | 预热 wall s | 加载及预热 wall s | 整进程 wall s |
|---|---|---|---|---|
| Eager(不开图) | 4.04 [4.02, 4.04] | 5.14 [5.09, 6.32] | 29.08 [28.87, 31.91] | 47.07 [46.49, 49.46] |
| TorchAir GE Graph | 1.11 [1.10, 1.14] | 47.74 [47.23, 63.04] | 71.58 [70.95, 86.81] | 86.02 [85.42, 101.04] |
| NPU Graph EX | 1.53 [1.53, 1.53] | 41.93 [41.77, 42.63] | 62.52 [62.41, 63.64] | 76.69 [76.52, 77.09] |
图后端在预热阶段支付了明显的准备成本,但这个数字包含一次 Prefill、一次 Decode、编译、capture 等工作,不是纯编译时间。对只启动一次并执行这一条短请求的进程,两种图后端的整进程 wall time 都高于 Eager;它们的优势体现在准备完成后的重复 Decode。
每轮都是新进程且 enable_cache_compile=False,但没有清理 CANN 算子缓存或 OS 文件缓存,所以不能把这组数字称为“完全冷启动”。NPU Graph EX 的成功首轮也发生在一次失败编译尝试之后。
8.4 输出验证与结论边界
所有 9 次成功运行都满足:进程正常退出、返回 64 个有效 token、记录 65 个正式 forward 时间并以 length 正常结束;图模式日志还必须出现编译触发和预热成功。两种图后端三轮生成的 token ID 完全相同;相对 Eager 都有 2/64 个 token 不同,文本相似度为 98.52%,超过 notebook 使用的 0.95 阈值。这只是单条 prompt 的粗粒度一致性检查,不代表困惑度、通用精度或逐 token 数值等价。
因此,本次实验能支持的结论是:在这个 A3、TP=1、batch=1、50-token prompt、64-token 输出的固定离线 workload 上,两种图后端都显著降低 Decode forward 时延,本组 GE Graph 快于 NPU Graph EX;但图模式增加了首次准备成本,且没有改善仍走 Eager 的 Prefill。
不应从这组数据外推“GE 永远比 NPU Graph EX 快”,也不能得出服务端并发吞吐、网络 TTFT、其他 batch / shape、峰值内存或 Host / Device 空洞的结论。三轮的最小值和最大值也不是置信区间。要定位加速究竟来自 Host 下发、kernel、访存还是调度,仍需另做一组带 profiler 的诊断运行。
9. Discussion:私货时间
以下是个人观点与趋势判断,不保证正确性。
9.1 数学和硬件才是长期竞争力
上层模型结构、框架接口和 Agent 概念更新太快,追着每一套新名词学,很容易一直在补课。我的取舍是:跟进应用变化,同时把更多积累放到数学与硬件系统上,因为它们能帮助我们理解一批又一批新方案。
数学告诉我们“哪些计算是必要的、哪些变换是成立的”;硬件告诉我们“这些计算怎样执行才划算”。 只会调用一个新 API,很难判断性能为什么变好、换个 shape 为什么又变慢。理解依赖、数值精度、存储层次和并行约束,才能把结论迁移到下一套模型与框架。
| 长期能力 | 看一个新方案时会追问什么 | 与本次分享的连接 |
|---|---|---|
| 数学与算法 | 运算能否等价改写?中间结果是否必要?精度、复杂度与近似误差怎样权衡? | 第 5 节中可以融合 SiLU 与残差相加,但不能把 residual 任意移到非线性之前 |
| 硬件与性能模型 | 瓶颈是算力、带宽还是启动延迟?数据放在哪里?Cube、Vector、搬运能否重叠? | 同样的融合,可能省下 GM 读写,也可能因片上资源压力而降低并行度 |
| 系统执行链路 | 框架调用最终变成什么任务?谁在调度?哪里同步?地址和资源何时可复用? | 从编译图追到 Runtime、Driver、SQE 与执行单元,解释图模式为什么有效 |
这里的“向下看”是把上层概念落到可解释的机制上:看到新模型,能拆出它的计算和数据依赖;看到新框架,能追到实际执行计划;看到 Agent 生成的代码,能判断它是否正确、是否解决了真正的瓶颈。框架会换,这套分析能力可以继续使用。
如果一年后今天的 API 和模型结构都换了,我们还剩下哪些可以直接复用的判断能力?
9.2 MegaKernel 是目前推理优化的终点,但之后呢
我的判断是:在大量小算子、反复启动、频繁中间结果搬运的推理路径上,MegaKernel 是很有价值的。这里把 MegaKernel 作为“大范围融合计算与执行”的讨论用语,不把它与某个具体 SuperKernel 产品能力完全等同。
图模式是框架层的优化,Kernel 融合的越多,图模式的收益就越小。另一方面,融的超大的 kernel 是没有迁移性可言的。
我们追求的究竟是哪几项性能收益?未来还需要人逐个手写复杂大 kernel,才能拿到这些收益吗?
先拆开融合算子的优势。 VV 融合主要展示减少中间数据搬运,CV 融合还展示不同执行单元之间的流水重叠。
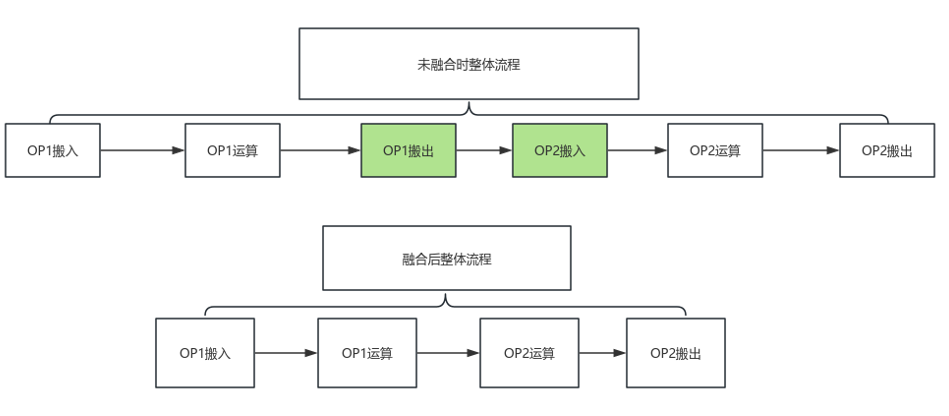
图中的绿色部分是 OP1 的搬出与 OP2 的搬入。若两段 Vector 计算能在同一片上数据块上连续完成,就可以省去这次中间结果写回 GM、再从 GM 读入的过程。对应第 5 节的例子,SiLU 后紧接 residual Add,融合实现可直接消费 SiLU 的片上结果。
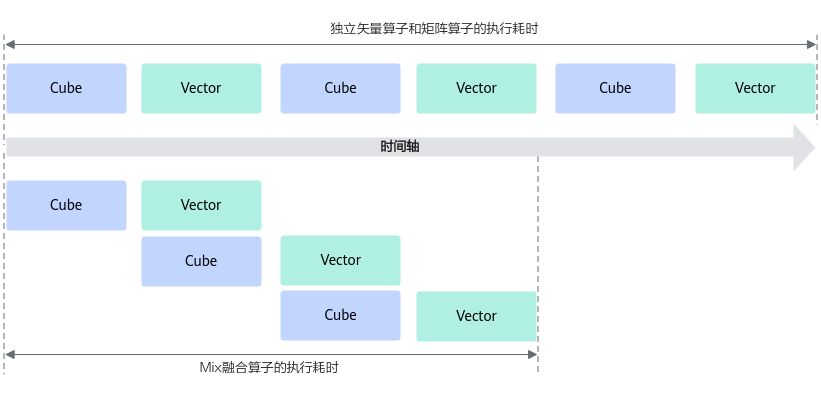
这张图强调的是流水重叠:某一块完成 Cube 计算后交给 Vector,Cube 接着计算下一块;不同数据块的 Cube 与 Vector 阶段因此可以重叠。同一数据块仍必须遵守先后依赖,图也不能用来证明所有 GM 搬运都被消除了。
两图从 05.02_fused_operator_concept_intro.ipynb 引用的 vv_process.png、mix_process.png 原样复制,是机制示意。
| 融合收益 | 为什么可能更快 / 更省 | 成立条件与边界 |
|---|---|---|
| 减少启动与调度 | 多次独立 kernel / Task 启动合并,缩短任务之间的间隙 | 要确认瓶颈中确实包含这些开销;Task 调度融合不等于数据已留在片上 |
| 减少中间访存 | 生产者结果直接供消费者使用,省去部分 GM 写回与读入 | 中间结果能留在片上,且数据布局、分块与消费者关系允许这样做 |
| 降低中间存储需求 | 部分完整中间 Tensor 不再物化,或复用已有存储 | 融合也可能增加寄存器、片上 buffer 或 workspace 需求,峰值内存须实际测量 |
| 提高执行单元利用率 | 分块组织 Cube、Vector 与数据搬运流水,减少相互闲置 | 需要合适的分块、同步和资源配比,不能跨越真实数据依赖 |
| 消除重复计算 | 联合分析后复用公共结果,或采用等价的算法改写 | 融合本身不会天然减少数学运算量;必须找到可消除的重复工作或更好的算法 |
Notebook 还提到简化代码。从调用者看,一个融合接口能隐藏多步运算;从实现者看,大 kernel 的 tiling、同步与边界处理往往更复杂。接口变简单与实现更容易维护,需要分开判断。
这些收益,能否从三个维度覆盖? 下表把机制与可承担它的工具对应起来,其中 Agent 一列和自动化覆盖范围属于发展方向,不是当前所有后端已经具备的能力。
| 要覆盖的收益 | 编译器 | 框架与调度器 | Agent 生成 |
|---|---|---|---|
| 减少启动与调度 | 自动识别可融合区域,生成融合实现或选择已有融合 kernel | 图捕获 / replay 减少 Host 反复提交;Task / SuperKernel 调度融合进一步压缩设备启动和调度间隙 | 生成融合 kernel 或任务编排方案,测量何种粒度更合适 |
| 减少中间 GM 读写 | 分析生产者 / 消费者关系,做分块融合、布局传播与片上数据复用 | 选择已有融合算子,减少不必要的格式转换与拷贝;单纯 replay 或把任务排紧,不能代替 kernel 内的数据复用 | 生成适配具体 shape 的 VV / CV 实现,搜索片上存储与数据搬运安排 |
| 降低中间存储需求 | 生命周期分析、消除中间物化、安全原地化和 buffer 复用 | 统一内存池、跨任务生命周期与回收时机;在正确同步后复用资源 | 探索 buffer 分配、重算与存储取舍,并检查越界、别名和内存占用 |
| 提高流水与并行度 | 联合选择 tiling、执行顺序与细粒度流水结构 | 根据依赖组织多流、计算通信重叠及任务流水;块级重叠需要 kernel / 任务接口支持 | 搜索分块、流水深度与同步策略,在目标设备上验证性能 |
| 减少重复计算 | 常量折叠、公共子表达式消除、代数变换与专门化 | 复用权重准备、编译和执行计划;算法结果缓存另需明确有效性条件 | 提出等价改写或专用算法,再用数值检查与实验筛选 |
三者可以接力:框架提供跨算子的依赖和运行信息,编译器把可证明的变换系统化,调度器管理执行与资源,Agent 探索尚未被稳定规则覆盖的实现。 如果编译器足够强,Agent 生成抽象维度较高的 kernel 也能编译出较好的性能;变化的是优化方法的生产方式,以及手工维护每个实现的必要性。 DeepSeek 开源昇腾基础组件
已有机制也说明这些路线可以结合:AOT SuperKernel 从 ACLGraph 的 Stream / Task 信息中识别可融合任务,再生成统一调度入口。这覆盖了部分任务启动与调度收益,但不能据此声称已经覆盖 VV 融合的全部访存收益。AOT SuperKernel:从图执行优化说起
所以我对“之后可能不是”的解释是:未来的主要投入点,可能从逐模型手搓 MegaKernel,转向可复用的编译规则、运行时调度能力,以及自动生成与验证体系。 融合仍然可能大量存在,只是越来越多地成为工具链产物。反过来,新硬件、新算法、极端 shape 或复杂通信也会持续制造工具链暂时覆盖不到的问题。
越多代码能够自动生成,人越需要判断数学变换是否成立、硬件资源是否用对、局部加速是否真的改善端到端性能。手搓高性能大算子的大师可能确实得把“才华埋葬在昨天”了。当然,昨天积累的优化经验,今天被沉淀成了可复用工具,然后继续解决新的问题。
附录 A:配图索引与来源
按正文出现顺序列出 9 张图片、7 张 Mermaid 图。博客图片副本保存在 /img/graph-mode/;本发布版的 Mermaid 图均以 PNG 展示;可编辑源码保留在 graphPresentation.md 中。原始图片文件记录见 图片来源清单。
| 编号 | 配图 / 形式 | 正文位置与讲解重点 | 来源与性质 |
|---|---|---|---|
| 01 | Eager 的 Host Bound 时间线 | 第 1 节:Host 下发间隙造成 Device 空洞 | vLLM-Ascend 推理优化;原文 Profiling 案例,非本组实测 |
| 02 | Eager 逐算子下发(PNG);原稿保留 Mermaid | 第 1 节:CPU 逐次下发、NPU 执行 | recipe 图模式原理,图 1;执行示意 |
| 03 | 图模式复用执行过程(PNG);原稿保留 Mermaid | 第 1 节:复用预先准备的任务集合 | recipe 图模式原理,图 2;执行示意 |
| 04 | Runtime 典型任务执行流程 | 3.2 节:任务提交、设备调度、同步与完成反馈 | 原 Runtime quick start 旧快照图片;保留的原始副本,来源路径说明见表后 |
| 05 | SQ / CQ 提交与回收(PNG);原稿保留 Mermaid | 3.2 节:SQE 入队、队列推进与资源回收 | 原 Runtime Stream 设计文档;对应实现的流程示意,来源路径说明见表后 |
| 06 | 图下沉的加载与执行(PNG);原稿保留 Mermaid | 4.1 节:提前下沉任务,模型执行任务触发运行 | GE 图下沉源图;教学示意 |
| 07 | ACLGraph 流与任务调度 | 4.1 节:Stream、Task 与依赖关系 | AOT SuperKernel:从图执行优化说起;调度结构示意 |
| 08 | Host tiling 参数刷新 | 4.3 节:回放时的参数更新与同步 | npugraph_ex 图模式优化;机制示意,第 7 节进一步解释 KV 长度变化 |
| 09 | MatMul → bias → SiLU → residual Add(PNG);原稿保留 Mermaid | 5.1 节:算子、shape、广播与 Tensor 依赖 | 本文按 y = SiLU(x @ W + b) + residual 绘制;逻辑计算图 |
| 10 | 四阶段到两阶段的融合对比(PNG);原稿保留 Mermaid | 5.3 节:减少 kernel 启动和中间 GM 读写 | 本文绘制;候选优化方案,不代表特定后端的实际编译结果 |
| 11 | TorchAir 架构 | 第 6 节:框架、编译后端与执行层的关系 | TorchAir 总览;架构图 |
| 12 | 编译缓存时间分布 | 第 6 节“编译缓存与 replay 缓存”:缓存减少哪些准备耗时 | TorchAir 编译缓存说明;原文案例,非本组实测 |
| 13 | 动态 FX 图与多个 ACLGraph 实例(PNG);原稿保留 Mermaid | 7.3 节:编译图复用与 Runtime capture 分属两层 | 本文绘制,依据 npugraph_ex 内存复用说明;教学示意 |
| 14 | Qwen3-8B 三种执行模式性能对比 | 8.2 节:Eager、GE Graph、NPU Graph EX 的 Decode 时延与吞吐 | 本仓实验记录;2026-09-29 在 A3 上的本组实测 |
| 15 | VV 融合流程 | 9.2 节:省去中间结果的搬出与搬入 | 融合算子概念教程 的 vv_process.png;原样复制的机制图 |
| 16 | CV 融合流水 | 9.2 节:不同数据块的 Cube / Vector 阶段重叠 | 融合算子概念教程 的 mix_process.png;原样复制的机制图 |
旧快照来源说明: 图 04 原记录为 Runtime 的 docs/zh/quick_start/figures/typical_process.png;图 05 原记录为 docs/zh/design/modules/stream/stream.md。这两条路径在当前本地 Runtime 快照中已不存在,讲稿中保留了图片副本和 Mermaid 源码。当前相关背景可参阅 Runtime 编程模型,但不将它当作两张旧图完全相同的原始来源。
旧版 Runtime 文档的网页原址未能确认,相关引用暂链接到 Runtime 仓库首页。历史路径还包括 docs/zh/design/architecture.md、docs/zh/design/modules/task/task.md、docs/zh/dev_guide/03-02_stream_management.md;这些路径在当前快照和可用本地历史中未找到,不将新的文档冒充旧版来源。
以上区分了机制示意、引用案例与本组实测:示意图不提供加速比,引用案例不能替代本组测量,第 8 节的实测结论也只对应记录中的模型、设备和测试条件。figs/ 中未被正文使用的备用素材不计入本索引。